Компании нужен не просто чат, который уверенно отвечает на вопросы. Нужно найти правильный пункт договора, объяснить изменение запасов, подготовить заявку или проверить редкую ситуацию на производстве. В осенних анонсах NVIDIA интересно именно разделение работы: Nemotron ведёт диалог и вызывает инструменты, Retriever помогает находить основания, Kumo строит прогнозы по структурированным данным, Cosmos работает с физическими сценами. Разберём, как из этих компонентов получается полезный бизнес-процесс и что имеет смысл проверять на локальной AI-станции.
Что опубликовано и какие сроки уже изменились
Обзор NVIDIA от 21 октября 2026 года объединяет несколько семейств с разными датами выпуска. Проверка для этой статьи выполнена 24 октября. Nemotron 3.5 Super VL и Bolt 74B были представлены 15 октября. Для компактного Bolt E4B тогда называли 23 октября — теперь это состоявшийся релиз, подтверждённый отдельной публикацией. Поэтому прежнюю формулировку «обещают до конца месяца» для E4B нужно обновить. NVIDIA: open-model portfolio, 21 October 2026 ↗ NVIDIA: Super VL and Bolt announcement, 15 October 2026 ↗ NVIDIA: Bolt E4B release, 23 October 2026 ↗
Для Alpamayo 2 Edge обзор по-прежнему указывает выпуск позднее в октябре. Здесь мы рассматриваем опубликованный анонс, не выдавая запланированную доступность за проверенный рабочий пакет. Наличие файлов модели, готовой библиотеки и подходящего серверного рецепта — тоже разные стадии: скачивание весов ещё не означает внедрение в компании.
| Семейство | Роль | Доступность и границы |
|---|---|---|
| Nemotron 3.5 Super VL | Диалог, визуальный контекст, вызовы инструментов | Модель опубликована; серверный рецепт проверяется под оборудование |
| Nemotron 3.5 Bolt 74B | Локальные агентные задачи | Опубликован, в том числе пакет 24GB |
| Bolt E4B 4GB | Компактный диалоговый помощник | Релиз подтверждён 23 октября 2026 |
| Nemotron Retriever | Разбор документов, поиск, переранжирование | Доступны отдельные модели и веса |
| Kumo и Kumo Engine | Прогнозы, связанные таблицы, подготовка данных | Доступны модели и библиотека; назначение компонентов различается |
| Cosmos 3 | Понимание сцен, генерация и симуляционные задачи | В документации доступны Edge, Nano и Super |
| Alpamayo 2 Edge | Специализированное автономное вождение | В анонсе 21 октября: выпуск позднее в октябре |
Nemotron: слой общения, понимания изображений и вызова инструментов
Super VL предназначен для мультимодальных агентных задач: текст, изображения и последовательность действий через подключённые инструменты. Bolt ориентирован на более компактное размещение. Например, опубликован вариант Bolt 74B-A9B 24GB с собственным форматом сжатия. Это характеристика конкретного пакета и поддерживаемого сценария, а не обещание одинакового потребления памяти на любой машине. NVIDIA: NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 · model-card snapshot ↗ NVIDIA: NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB · model-card snapshot ↗
Бизнес-пример — помощник сервисного отдела. Сотрудник прикладывает фотографию маркировки и спрашивает, какие документы нужны для заявки. Модель помогает прочитать изображение, затем приложение обращается к разрешённому каталогу и создаёт проект карточки. Если исполнение оборудования не определено, помощник уточняет его. Работа с изображением не заменяет проверку, что инструкция относится к нужной версии.
Bolt E4B интересен как кандидат для коротких диалогов и многошагового обращения к инструментам. В голосовом сценарии нужны ещё распознавание и синтез речи: одна языковая модель не является всем голосовым трактом. В пилоте оцениваются разбор запроса, правильность параметров и время до принятого результата, включая остальные компоненты.
Польза системы определяется тем, дошёл ли сотрудник до проверенного результата. Красивый ответ — только один этап.
Retriever: почему качество поиска иногда важнее размера модели
Nemotron Retriever объединяет несколько специализаций. Parse превращает изображение страницы в структурированный текст с элементами разметки и порядком чтения. Это помогает не потерять связь заголовка с таблицей или подписи с изображением. Ошибки разбора всё равно проверяются на реальных формах документов. NVIDIA: Nemotron-3.5-Parse · model-card snapshot ↗
Embedding-модель представляет запросы и материалы в форме, удобной для поиска похожего содержания. Переранжировщик затем оценивает, какие из найденных кандидатов точнее отвечают вопросу. В опубликованных Nemotron 3.5 Embed и Rerank предусмотрена работа с текстом и визуальными документами. Они выбирают доказательства для ответа, а генератор формулирует объяснение. NVIDIA: Nemotron-3.5-Embed-1B-BF16 · model-card snapshot ↗ NVIDIA: Nemotron-3.5-Rerank-8B-BF16 · model-card snapshot ↗
Представим запрос закупщика: «Какой срок поставки согласован для этой позиции?» В папке лежат договор, спецификация и несколько предложений с разными датами. Парсер извлекает структуру, поиск находит кандидатов, переранжирование выделяет релевантные фрагменты. Но действительность версии задаётся отдельными метаданными: релевантный старый файл не становится актуальным только потому, что хорошо совпал с вопросом.
Полезный выход — срок со ссылкой на конкретную страницу, версией документа и отметкой о противоречии, если оно есть. Разрешения проверяются до передачи фрагментов модели. Такой сценарий применим к договорам, инструкциям, техническим каталогам и внутренним регламентам.
Kumo: прогноз по таблицам вместо правдоподобного пересказа Excel
Kumo включает модели для одной таблицы, связанных таблиц, временных рядов и поиска аномалий. Это прогнозные задачи: классификация, оценка числового результата или поиск необычного поведения. Текстовый помощник может объяснять вывод и задавать уточнения, но не должен подменять расчёт прогнозной модели произвольным числом. NVIDIA: Kumo models and libraries ↗
Для связанных данных важно сохранить смысл связей: клиент — заказы — позиции — поставки. Выгрузка в одну длинную текстовую строку теряет часть этой структуры. В проекте сначала определяются идентификаторы, временные отметки, целевая величина и доступные на момент решения сведения. Затем проверяется, достаточно ли истории для выбранной задачи.
Допустим, торговая компания хочет понимать, для каких позиций вероятен недостаток товара в следующем периоде. Здесь требуются история спроса, сведения о наличии, сроки поставки и согласованный горизонт. Forecast может быть кандидатом для прогноза ряда; его карточка описывает сочетание модели с поиском исторических паттернов. Превратить прогноз спроса в заявку на закупку должны отдельные правила с учётом уже заказанного товара и ограничений компании. NVIDIA: Kumo-Forecast · model-card snapshot ↗
Для оборудования можно исследовать другой сценарий: необычная динамика показателей датчиков. Сигнал аномалии направляется специалисту вместе с временным интервалом и исходными значениями. Он не является готовым диагнозом неисправности. Важно заранее посчитать, сколько лишних уведомлений команда сможет обработать.
Зачем отдельно нужен Kumo Engine
Вокруг Kumo есть несколько библиотек. Предобученные Tabular и Relational запускаются через Structured Data Models, а Forecast и Anomaly — через Kumo-TS. Kumo Engine решает отдельную задачу: готовит контекст связанных записей и поддерживает обучение и пакетное прогнозирование. Его README описывает индексирование на SSD и выборку данных с учётом времени; код опубликован под Apache 2.0. NVIDIA Kumo Engine · source snapshot ↗
Практический смысл для компании — получить управляемую работу с историей и отношениями между таблицами, когда плоского отчёта уже недостаточно. Но это не кнопка «загрузить бухгалтерию и получить все ответы». Потребуются схема данных, выбранная прогнозная задача, проверка качества и подходящая инфраструктура. Для небольшого первого пилота полный обучающий контур может оказаться избыточным.
Четыре примера применения в компании
В первом сценарии менеджер собирает ответ клиенту по документам. Retriever помогает отобрать основания, Nemotron подготавливает текст, сотрудник проверяет источники и условия. Во втором планировщик получает прогноз спроса, сопоставляет его с простым базовым методом и рассматривает варианты запаса. В третьем сервисная команда изучает необычные временные ряды. Четвёртый относится к промышленной разработке — подготовке и оценке синтетических сцен.
| Процесс | Что подготовить | Результат | Как проверить |
|---|---|---|---|
| Ответ по договору или инструкции | PDF, изображения страниц, версии и права | Нужные основания + черновик ответа | Правильность источника и время проверки |
| Планирование запасов | История спроса, наличие, поставки | Прогноз + проект решения планировщика | Ошибка прогноза против базового метода |
| Мониторинг оборудования | Временные ряды измерений | Необычный интервал для специалиста | Пропущенные события и лишние уведомления |
| Промышленная визуальная система | Реальные сцены и заданные условия | Синтетические примеры для испытания | Качество конечной системы на реальных данных |
Эти сценарии описывают возможный проект, а не наши выполненные внедрения. В публичном материале Databricks от 21 октября уже описано использование Kumo для структурированных прогнозов и Retriever для поиска оснований внутри её рабочих процессов. Это пример направления интеграции, заявленного самой компанией; из него нельзя выводить экономию или качество для чужой базы. Databricks: NVIDIA model integration announcement ↗
Cosmos: понять и смоделировать физическую сцену
Для Cosmos 3 документация перечисляет три основных размера: Edge — 4B, Nano — 16B, Super — 64B параметров. Семейство разделяет поверхности понимания сцены и генерации: результаты зависят от конкретного режима и интеграции. Эти обозначения полезнее абстрактного обещания «модель для всего физического мира». NVIDIA: Cosmos 3 model reference and sizes ↗
Складской или производственной команде может быть интересна подготовка редких ситуаций для обучения и проверки визуальной системы. Например, как меняется вид сцены при перекрытии части объекта или необычном освещении. Октябрьское обновление Cosmos Data Factory включает работу с подбором, разметкой, генерацией и оценкой данных для физических сценариев. Применение к конкретному складу потребует своих материалов и критериев. NVIDIA: Cosmos training, evaluation and data workflows ↗
Сгенерированное видео само по себе не подтверждает физическую выполнимость маршрута и не измеряет реальную производительность склада. Для этого нужны инженерная модель, ограничения среды и проверка на фактических данных. Разумный пилот сравнивает качество конечной системы на независимом наборе реальных сцен до и после добавления синтетики.
Alpamayo 2 Edge относится уже к специализированному автомобильному направлению. В анонсе указана оптимизация под DRIVE AGX Thor и задачи понимания обстановки и планирования движения. Это отдельный инженерный проект с собственными испытаниями, не готовый автопилот для обычной офисной AI-станции. Для большинства компаний начать с документов и таблиц гораздо ближе к повседневной работе.
Как собрать из моделей рабочий процесс
Предлагаемая архитектура выбирает компоненты по типу входных данных. Документы идут в разбор и поиск, таблицы — в прогнозную обработку, физические сцены — в отдельный исследовательский контур. Общий интерфейс помогает сотруднику видеть источники, статус задания и следующий шаг. Нет необходимости загружать все семейства ради одного сценария.
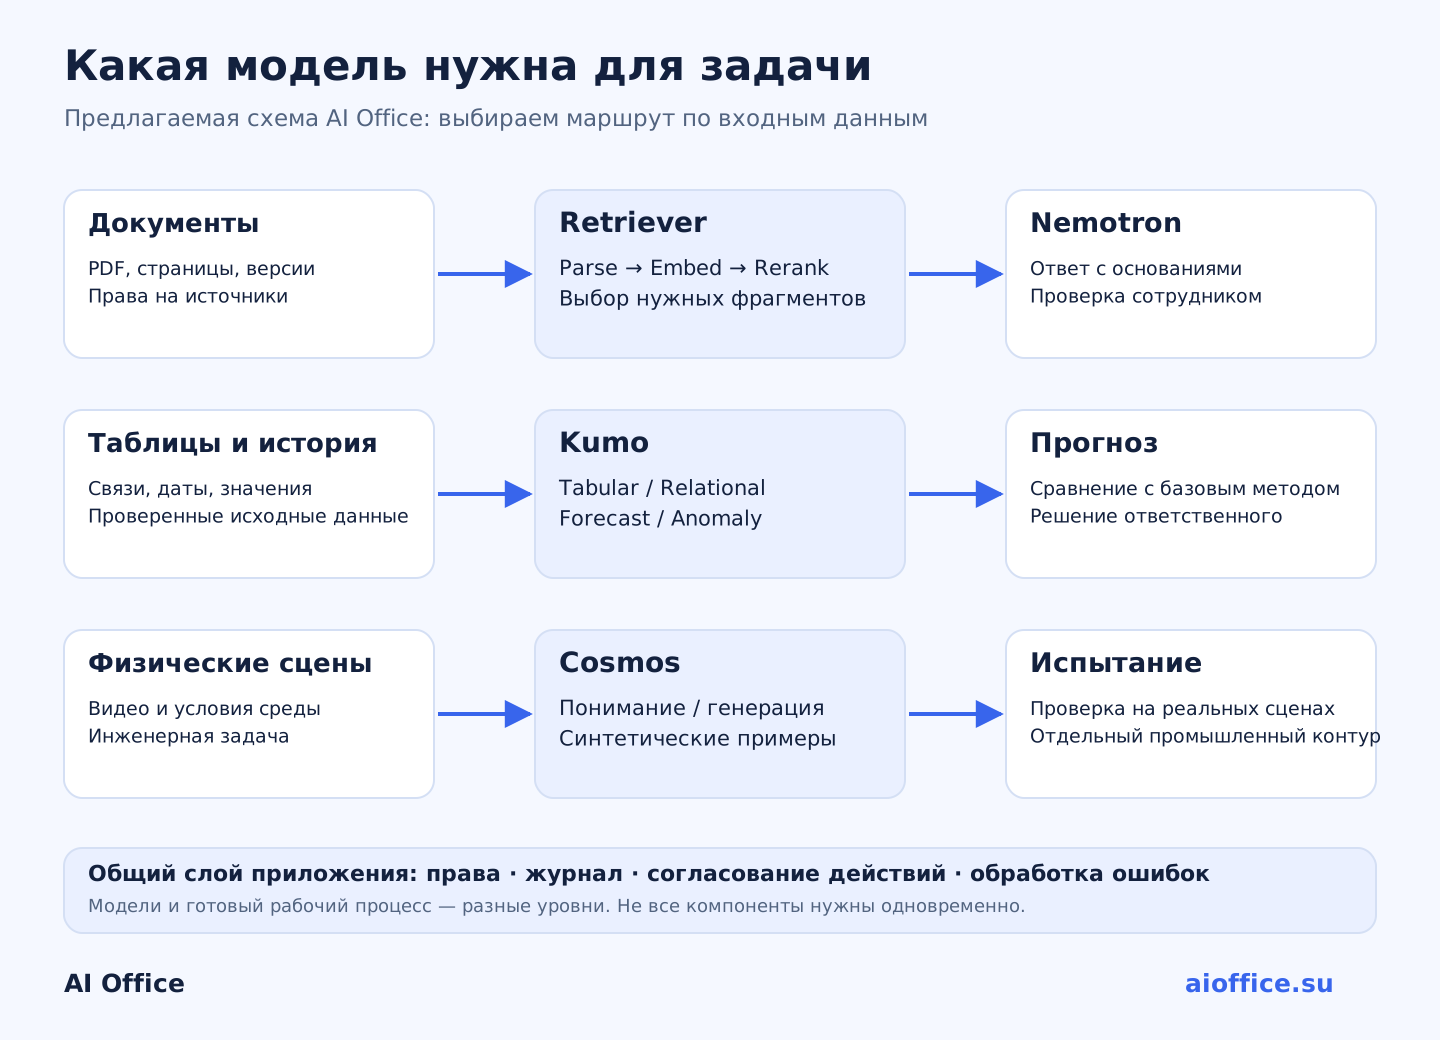
Запись в 1С, отправка письма или изменение плана поставки выполняются через согласованные инструменты приложения. Прогноз не получает полномочий на закупку просто потому, что он убедительно объяснён. Для действия нужны актуальные данные, ответственный и фиксация результата, включая поведение при сбое связи.
Что реально означает локальный запуск
Открытые веса дают возможность рассматривать собственное размещение. Совместимость остаётся отдельным вопросом. Многие опубликованные рецепты NVIDIA используют её GPU и программный стек; документация Engine также задаёт требования к среде, SSD и обучающим GPU-сценариям. Для станции на другой платформе нельзя автоматически обещать поддержку всех этих пакетов.
Даже при 128 ГБ памяти нужно проверить формат весов, длину контекста, визуальные входы, очередь запросов и запас для приложения. В MoE число активных параметров не равно полному размеру модели. Пакеты с обозначениями 24GB или 4GB не описывают память всего рабочего комплекса. Выбираем совместимый набор под задачу, а не пытаемся одновременно уместить весь каталог моделей.
Условия использования тоже проверяются по каждому компоненту: например, у Engine и ряда прогнозных моделей указана Apache 2.0, у других пакетов — OpenMDW 1.1. Это разные документы, а не единая лицензия на всю подборку. Локальность всего процесса требует отдельно проверить, куда отправляют данные OCR, поиск, телеметрия и интеграции.
С какого пилота начать
Для поиска подготовьте вопросы с известными ответами, действующими источниками и примерами, где данных недостаточно. Оцените отдельно нахождение нужного фрагмента и правильность объяснения. Для прогнозов разделите историю по времени, чтобы будущие события не попали в обучение или контекст. Сравните результат с понятным базовым прогнозом, а не только с красивым графиком.
Добавьте измерение времени проверки сотрудником и числа существенных исправлений. После этого решайте, какие роли и инструменты расширять. В AI Office мы готовы разобрать процесс компании, выбрать совместимые компоненты и разработать индивидуальную связку с её документами и учётными системами. Начать стоит с одного повторяющегося задания, для которого можно проверить качество и полезность результата.