Небольшая локальная модель, несколько рабочих ролей и общая папка с планом — такая конструкция в эксперименте GVS5H приблизилась к Claude Fable 5 на сложных задачах программирования. Веса модели не дообучали. Меняли то, как ей поручают работу, сохраняют промежуточные выводы и возвращают ошибки на исправление. Это интересный аргумент в пользу локального ИИ, если правильно прочитать результаты. GVS5H · repository snapshot and experiment overview ↗
Для компании практический вопрос звучит так: можно ли получить более полезного помощника из уже доступной модели, прежде чем покупать более дорогой сервис или новое оборудование? Разберём данные авторов, устройство метода и три сценария, которые разумно проверить на собственных задачах. Материалы сверены 27 октября 2026 года; AI Office изучил исходники и опубликованные результаты, но не воспроизводил вычислительный эксперимент.
Что на самом деле означает «пять моделей уровня Claude»
GVS5H расшифровывается как Gorilla vs. 5 Humans. Название обыгрывает идею команды против одного сильного исполнителя. В реализации это не пять разных нейросетей с разными профессиями и не обязательные пять копий весов в памяти. Менеджер и работники — свежие вызовы одной и той же модели. Оркестратор передаёт им состояние через файлы. Число вызовов меняется по ходу решения. GVS5H · repository snapshot and experiment overview ↗
Агент здесь — модель с конкретным поручением и доступным ей контекстом. Один вызов составляет план, другой предлагает подходы, следующие выполняют отдельные шаги. Новая сессия не получает всю предыдущую переписку: программа собирает для неё нужные материалы из рабочего каталога. Для локального развёртывания это важное различие: роли можно обслуживать последовательно одним сервером модели. GVS5H v2 · manager, workers, file ledger and sample verifier ↗
Отсутствие дообучения означает, что веса не изменяются. Однако каждый дополнительный вызов расходует время и вычисления. Организация работы даёт модели больше возможностей дойти до решения; она не превращает сложную задачу в бесплатную.
Что показал LiveCodeBench
Авторы выбрали 100 наиболее поздних по дате соревнования сложных задач из LiveCodeBench release_v6. Для основной серии сделали по пять проходов каждой конфигурации с включённым рассуждением и пределом 128 тысяч выходных токенов на вызов. Это ограничение одного ответа, а не суммарный бюджет всей команды. Одиночную генерацию Qwen3.8-27B при 128k оценили усечением сохранённых ответов, изначально полученных с пределом 250k. Gao et al. · GVS5H paper, pinned version ↗
| Модель | Один вызов, % | С менеджером, % | Прирост, п.п. |
|---|---|---|---|
| Claude Fable 5 | 90,4 ± 1,4 | Не исследован | — |
| Qwen3.8-27B | 66,8 ± 5,2 | 92,4 ± 2,3 | +25,6 |
| Qwen3.8-Flash-Next | 84,2 ± 1,8 | 93,0 ± 1,2 | +8,8 |
| DeepSeek-V4.1-Flash | 88,4 ± 2,6 | 92,0 ± 1,8 | +3,6 |
| GPT-5.6-Terra | 80,8 ± 1,0 | 88,0 ± 1,2 | +7,2 |
| GPT-5.6-Luna | 70,4 ± 4,6 | 81,2 ± 2,8 | +10,8 |
В таблице — средний pass@1: доля задач, для которых итоговое решение прохода выдержало скрытые тесты. В режиме менеджера такое решение могло появиться после нескольких внутренних вызовов и исправлений. Пять проходов нужны для оценки разброса; результат 92,4% не означает, что любую рабочую задачу достаточно задать один раз и с такой вероятностью получить готовый продукт. GVS5H · five-pass scores, confidence intervals and statistical comparisons ↗
Для Qwen3.8-27B прирост к собственной одиночной версии составил 25,6 процентного пункта. Разница относительно Fable 5 — только 2 пункта, для Flash Next — 2,6. В статистических тестах авторов эти два превышения над Fable 5 незначимы. Корректный вывод: на этой выборке система показала сопоставимый уровень, а убедительный прирост получен относительно той же модели без оркестрации. GVS5H · five-pass scores, confidence intervals and statistical comparisons ↗
LiveCodeBench проверяет решение программных задач по тестам. Это полезный измеритель, но он не оценивает весь цикл разработки в компании: работу с большим наследуемым проектом, согласование требований, поддержку пользователей или изменения в 1С. Датированные задачи помогают учитывать риск попадания примеров в обучение, однако дата внутри старого релиза сама по себе не доказывает новизну для более поздней модели. LiveCodeBench · benchmark scope and dated evaluations ↗
Общая папка как рабочая память
В каталоге задачи находятся task.md с условием, plan.md с планом, tasks.json со списком задач, notes.md с отобранными выводами и solution.py с текущим кодом. Между вызовами остаётся понятное состояние работы. В v2 менеджер выбирает одно следующее поручение, работник обновляет решение и заметки, затем управление возвращается менеджеру. Есть предел в десять циклов и остановка при повторении того же поручения без продвижения. GVS5H v2 · manager, workers, file ledger and sample verifier ↗
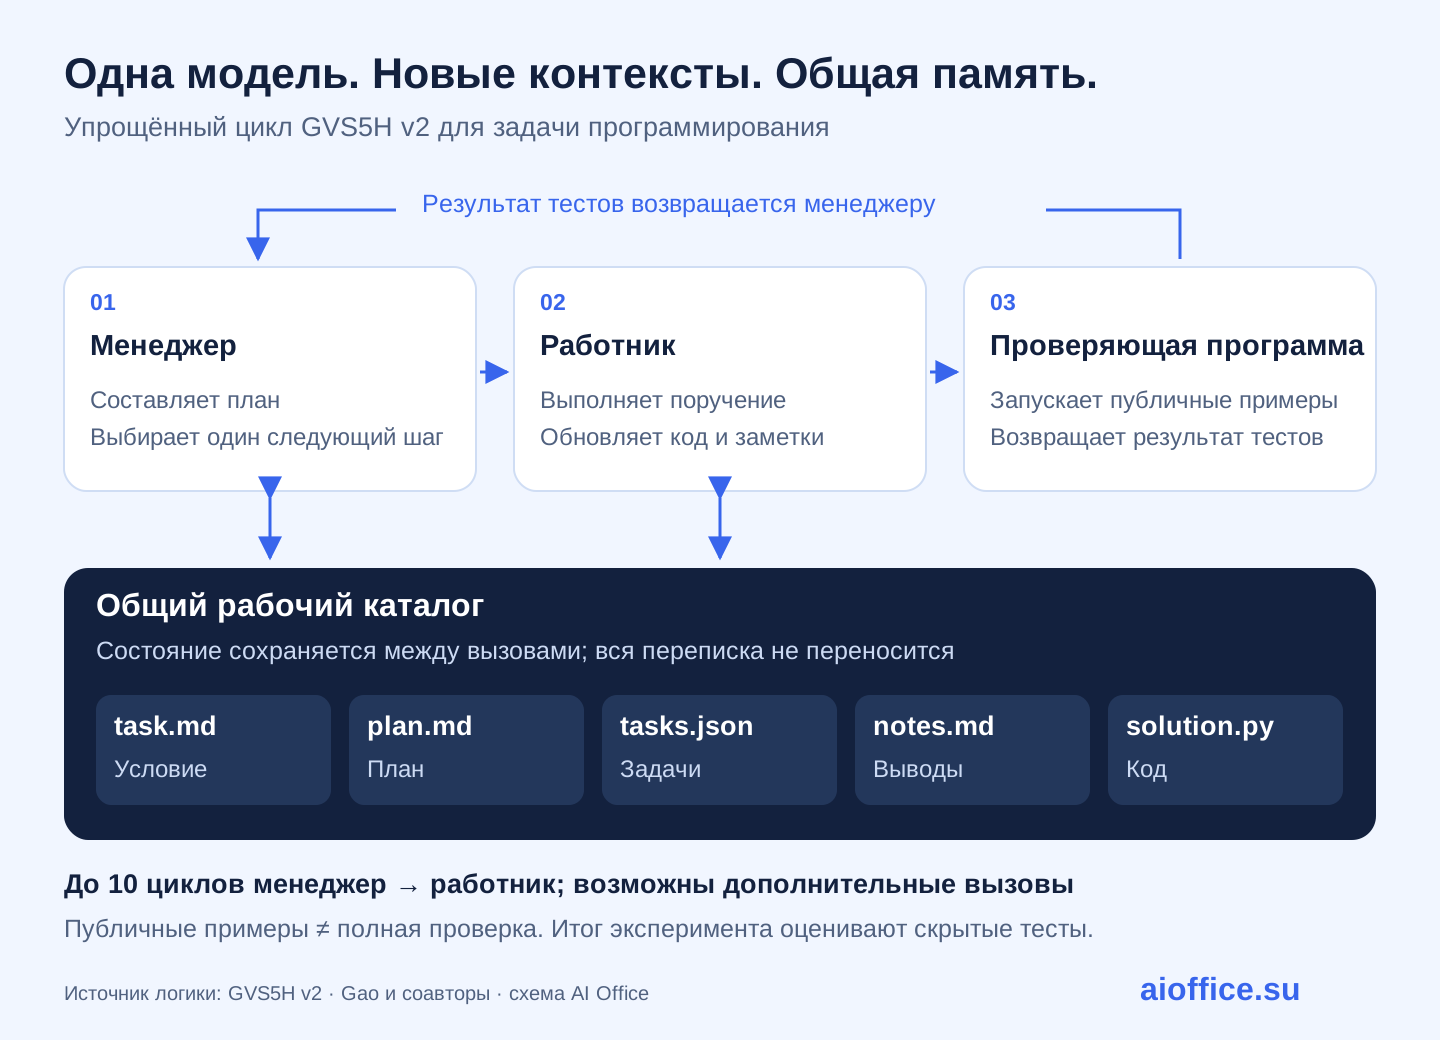
Программный проверяющий запускает доступные публичные примеры и сообщает результат менеджеру. Это не ещё одна нейросеть, которая просто говорит «кажется, верно». В исследовании такая обратная связь была доступна для 73 задач со стандартным вводом; 27 задач другого формата её не получали. Окончательную оценку ставили скрытые тесты. Gao et al. · GVS5H paper, pinned version ↗
Польза общей памяти понятна на бытовом примере. Если при каждом поручении заново пересказывать всю историю, легко потерять уже найденное правило или вернуться к отвергнутой гипотезе. Короткий рабочий журнал позволяет передать следующему исполнителю решение, аргументы и конкретную ошибку. Но неверный вывод в журнале тоже передаётся дальше. Поэтому нужны проверяемые результаты, а не только уверенные записи.
Откуда взялись «9% стоимости»
Число относится к Qwen3.8-Flash-Next с менеджером. В расчёте авторов один проход по 100 задачам оценён в $5,76 против $61,11 у одиночного Fable 5: около 9,4%. Для Qwen3.8-27B с менеджером указано $47,82 — около 78,3% стоимости Fable 5. Распространять цифру «9% от стоимости» на 27B-модель было бы ошибкой. GVS5H · token-based cost estimates for 100-problem passes ↗
| Модель | Один вызов | С менеджером | К стоимости Fable 5 с одним вызовом |
|---|---|---|---|
| Claude Fable 5 | $61,11 | Не исследован | 100% — база |
| Qwen3.8-27B | $18,95 | $47,82 | 78,3% с менеджером |
| Qwen3.8-Flash-Next | $2,73 | $5,76 | 9,4% с менеджером |
Это расчёт «использованные токены × выбранные тарифы», а не измеренная себестоимость локального сервера. Qwen в эксперименте обслуживался через собственный vLLM, но для сравнения авторы применили публичные ставки. Их таблица фиксирует условия исследования, а не действующее коммерческое предложение; тарифы и скидки могут меняться. GVS5H · token-based cost estimates for 100-problem passes ↗
В компании стоит считать стоимость принятого результата: вычисления или API, обслуживание, время ожидания, проверку сотрудником и доработки. Локальная станция может сократить передачу данных внешним сервисам и дать контроль над загрузкой, но сама по себе не гарантирует более дешёвую задачу. Иногда быстрый одиночный ответ полезнее длинного цикла из множества вызовов.
Сценарий 1: сверка выгрузок и небольшой инструмент для отдела
Представим отдел закупок, который регулярно сравнивает прайсы поставщиков с внутренним каталогом. Названия отличаются, упаковки содержат разное количество единиц, часть артикулов дублируется. Здесь интересен помощник, который подготовит проверяемый инструмент обработки таблиц. Это предлагаемый сценарий, а не опубликованный кейс GVS5H или внедрение AI Office.
Менеджер фиксирует правила сопоставления и единицы измерения. Один проход выявляет спорные поля, другой пишет преобразование, следующий разбирает ошибки на контрольной выборке. В журнале остаются принятые правила и неразрешённые исключения. Итогом должны стать код, отчёт о расхождениях и список строк для ручного решения.
Проверка строится на заранее размеченных примерах: совпадение артикула, пересчёт упаковки, пустая цена, повторная строка. ИИ не должен объявлять два товара одинаковыми только ради красивой итоговой таблицы. Пользу измеряем временем до принятого отчёта и числом исправленных сотрудником ошибок. Если разбор исключений стал дольше ручной сверки, выбранная схема не даёт выгоды.
Сценарий 2: подготовка интеграции с 1С
Компания хочет переносить подтверждённые заказы из внешней системы в тестовую базу 1С. Подход с рабочим журналом можно использовать для подготовки описания полей, преобразования данных, черновика интеграции и тестов. Это перенос принципа на другую задачу: исследование GVS5H не проверяло BSL, MCP-серверы или реальные базы 1С.
В общем каталоге сохраняются утверждённая схема обмена, примеры обезличенных заказов, ответы тестового интерфейса и перечень ошибок. Менеджер выделяет шаг: например, обработать повторную отправку заказа. Работник меняет только соответствующий участок, а проверяющая программа отправляет тестовые запросы и сверяет результат.
Критерии приёмки задаёт специалист по 1С: обязательные реквизиты, совпадение количества и сумм, корректная обработка повторов, отсутствие лишних изменений. Создание или проведение документов в рабочей базе — отдельное разрешённое действие после проверки. Оркестрация помогает организовать разработку; права доступа и ответственность за учёт проектируются отдельно.
Сценарий 3: доработка внутреннего приложения
Например, сервисная компания добавляет в диспетчерскую систему расчёт просрочки заявок с учётом рабочего календаря. Ошибки обычно прячутся в переходах: выходные, неполные данные, смена статуса, часовые пояса. Поручение «добавь расчёт» легко оставляет эти условия за кадром.
Рабочий журнал может хранить согласованные правила, список затронутых файлов и результаты проверок. Менеджер выделяет очередной шаг, работник предлагает изменение, автоматические тесты проверяют ожидаемые даты и прежнее поведение. Сотрудник получает пакет для ревью: что изменилось, почему, какие случаи проверены и какие вопросы остались.
Такую схему нужно оценивать на собственном проекте. Успех на алгоритмических задачах не доказывает, что агент правильно поймёт незнакомую архитектуру. Для пилота подходит ограниченное изменение с понятной приёмкой и возможностью отката. Полезная метрика — время разработчика до принятого изменения, включая исправление ошибок ИИ.
Можно ли запустить это на локальной AI-станции
Механика общего журнала не требует конкретного облачного провайдера. У Qwen3.8-27B опубликованы открытые веса; в GVS5H авторы использовали локальное обслуживание в FP8. Но это не тест нашей станции класса 96–128 ГБ: выбранная сборка, ускоритель, длина контекста и число одновременных запросов требуют отдельной проверки. Qwen3.8-27B · official model-card snapshot ↗
С Flash Next особенно важно не путать активные параметры с объёмом всей модели. Официальная карточка указывает 125B параметров с 6B активными, плюс отдельные n-gram embeddings и MTP. Низкая активная доля не означает, что для хранения всех весов нужна память как для 6B-модели. Результаты Flash Next нельзя автоматически переносить на любой мини-ПК. Qwen3.8-Flash-Next · official parameter breakdown ↗
Последовательные роли позволяют переиспользовать загруженные веса. При этом большой контекст, KV-кэш и длинные ответы всё равно потребляют память и время. Для начала можно проверить одну подходящую локальную модель на коротком рабочем цикле. Подключение облака оставляют управляемой опцией, заранее определяя, какие данные разрешено передавать.
Что нужно добавить перед рабочим использованием
Репозиторий — исследовательская реализация, а не готовый корпоративный продукт. В изученной функции проверки примеров сгенерированный Python запускается через subprocess с тайм-аутом. Такой запуск сам по себе не является изолированной средой. Для рабочего решения нужны отдельный пользователь или контейнер, ограничения сети и файлов, лимиты ресурсов и отсутствие производственных секретов в среде исполнения. GVS5H v2 · manager, workers, file ledger and sample verifier ↗
Лицензирование тоже разделено: собственный код — MIT, статья, иллюстрации и результаты прогонов — CC BY 4.0; условия задач и сторонние компоненты сохраняют свои лицензии. Можно изучать и адаптировать код в рамках применимых условий, но нельзя считать весь каталог одним пакетом с единой лицензией MIT. GVS5H · licensing by repository path ↗
В основной серии все пять моделей с двумя режимами получили прирост, однако в дополнительных условиях эффект различался. Например, для Qwen3.6-35B с выключенным рассуждением результат снижался. Ранний неудачный план способен направить последующие вызовы по ошибочному пути. Значит, число агентов само по себе не должно становиться целью проекта. GVS5H · separate original-scaffold experiments, including regressions ↗
Перед выводом о качестве также важно учитывать исправления оценщика: авторы изменили обработку неединственных правильных ответов и выполнение программ, после чего пересчитали результаты. Это описанные ими изменения методики; независимое воспроизведение AI Office не проводил. GVS5H · corrected per-problem verdict data ↗
Как проверить идею в своей компании
Выберите один повторяющийся процесс с проверяемым результатом. Соберите, например, 20–30 обезличенных задач, заранее задайте критерии приёмки и сравните одиночный вызов с циклом «план — действие — проверка» на одной модели. Число задач — предложение для стартового пилота, не стандарт научной оценки. Ошибки в денежных расчётах и изменения данных учитывайте отдельно от мелких замечаний.
Замеряйте долю принятых результатов, время сотрудника, полное время выполнения и стоимость. Сохраняйте версию модели, правила, входные данные и итоговые файлы. Добавьте остановку по бюджету и путь к ручной обработке. Хороший результат пилота — понятное улучшение конкретного процесса, которое повторяется на новых примерах.
GVS5H даёт повод проверять качество организации работы вместе с размером модели. В AI Office можно разобрать такой процесс, подобрать локальную модель и спроектировать ограниченный пилот с проверкой результата. Начать стоит с одной задачи вашей команды: её входных файлов, критериев готовности и допустимых действий.